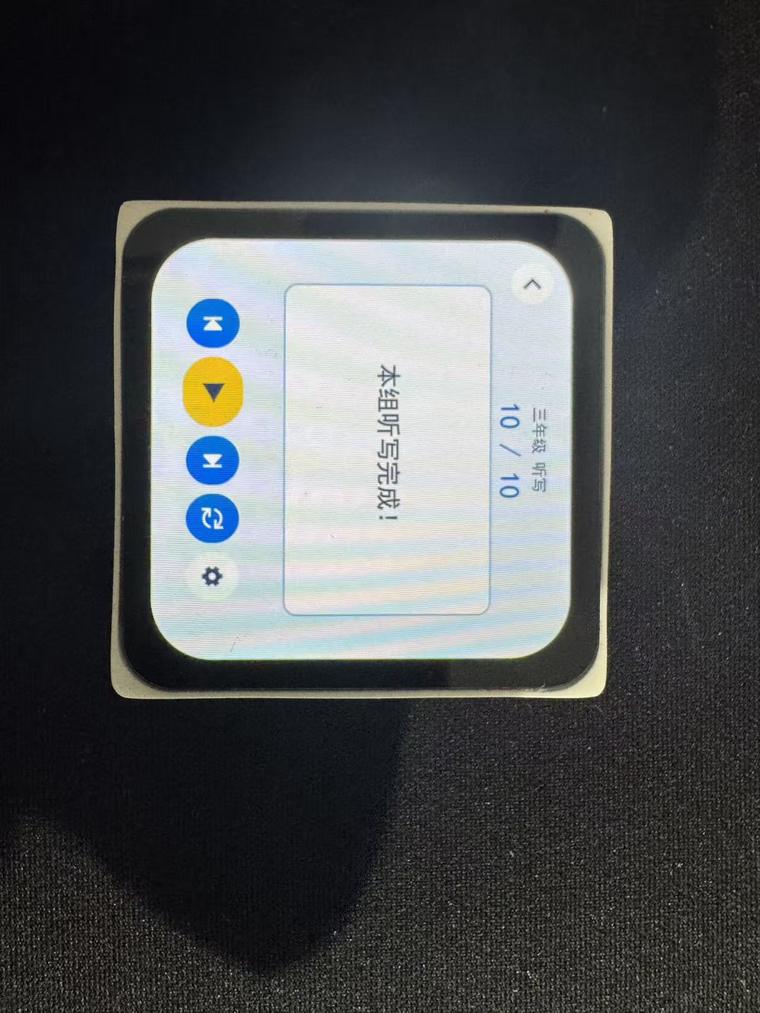
给孩子做了台“看不到答案”的英语听写机:拍照布置作业,ESP32 只听不看
孩子上小学以后,每天有英语听写作业。
这件事的麻烦在于:得有人一遍一遍读。家长读,费嗓子、发音不一定标准、读错一个词孩子就跟着错;用 App,广告多,孩子点两下就滑去玩别的了。
于是我给自己家做了一个专用工具,叫「搞定听写」。现在它长这样:
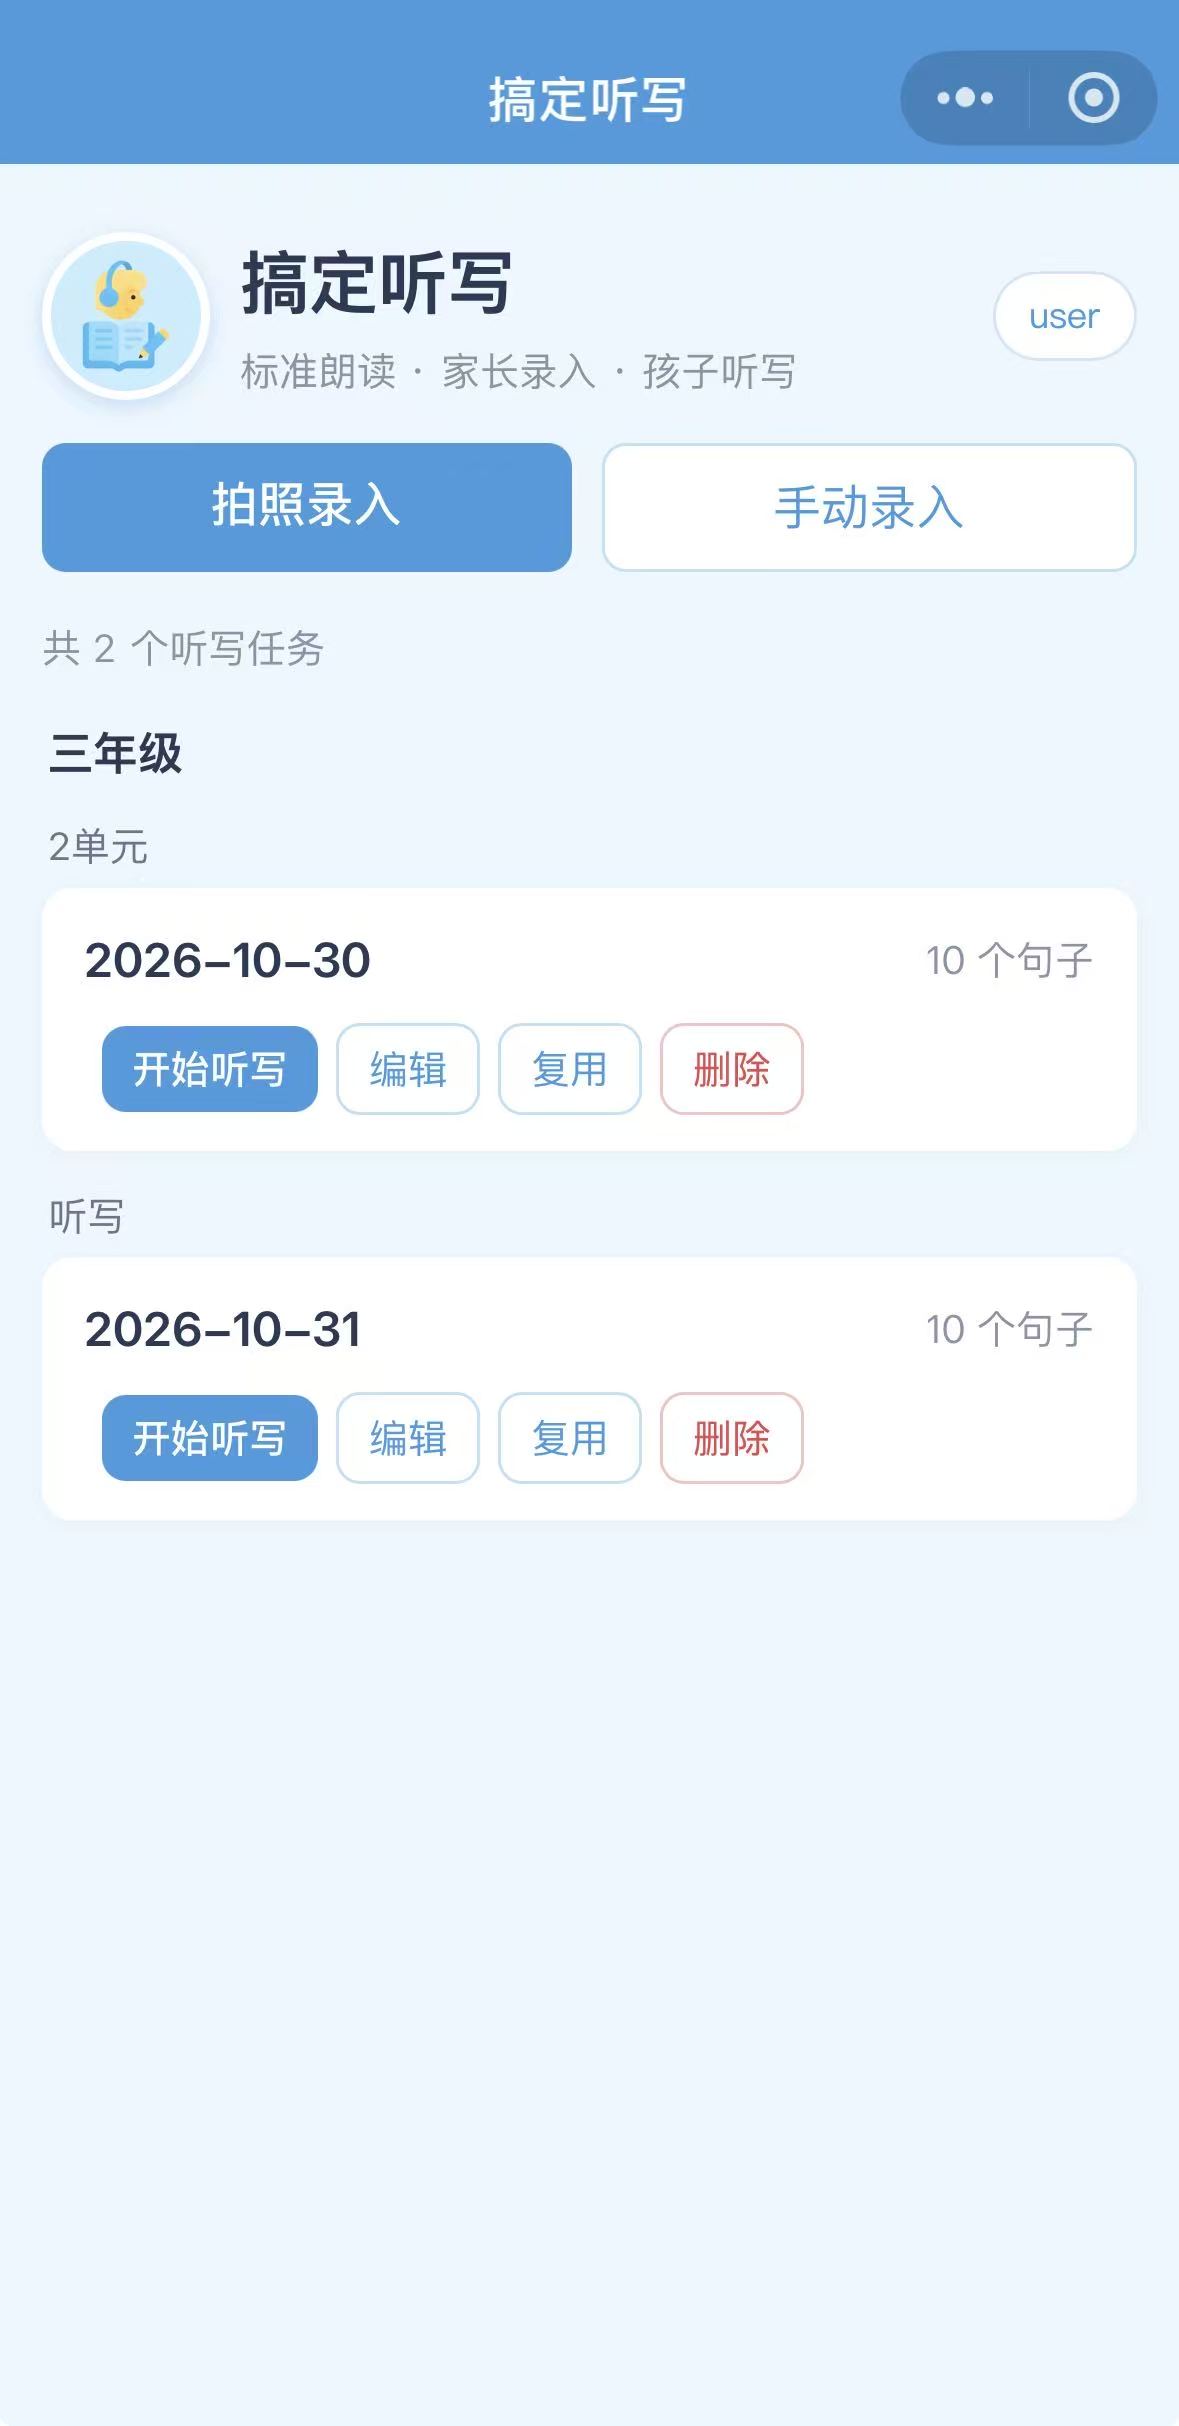
- 家长在微信小程序里对着教材拍张照,AI 认出英文句子,人工核对后保存成一次"听写任务";
- 孩子打开小程序,或者用一台专门的听写机,逐句听标准发音写下来;
- 那台听写机上,句子默认是看不见的,手指按住才临时显示——想偷看,得先承认自己在偷看。
从写下第一版架构文档到三端跑通,用了 9 天。期间踩的坑比写的代码多,这篇把设计和坑一起记下来。
一、三端各干什么
| 端 | 谁用 | 干什么 |
|---|---|---|
| 微信小程序 | 家长 | 拍照录入、手动录入、任务增删改、生成设备配对码、查看设备与解绑 |
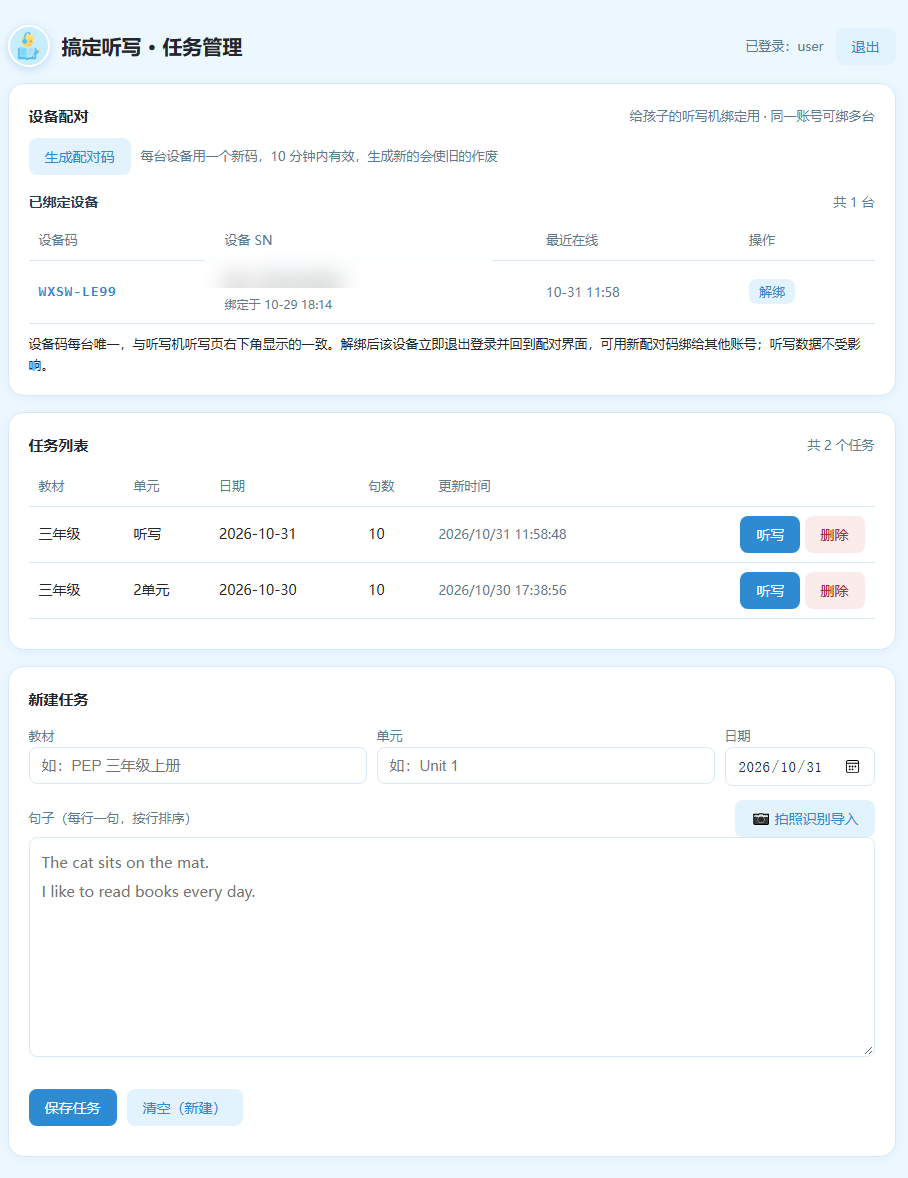
| 网页管理台 | 家长 / 管理员 | 同一套账号与数据;任务管理、网页版听写器、设备管理、用户审核 |
| ESP32 听写机 | 孩子 | 连 WiFi、输配对码绑定、选任务、逐句听、断点续听。只能听,不能改 |
这里有个刻意的分工:孩子端没有任何"编辑"能力。任务内容完全由家长账号决定,听写机连解绑按钮都没有——要解绑,只能家长在手机上操作。这不是技术限制,是产品决定:一台能自己解绑的机器,等于一台可以不写作业的机器。
二、家长怎么布置一次听写
三步,全程不用开口读。
- 拍照:对准教材上要听写的那一页拍下来。服务端调视觉模型识别,返回一个英文句子数组。
- 核对:识别结果逐句列出来,可改、可删、可加。教材排版千奇百怪,这一步不能省——AI 认出 95% 也不够,剩下 5% 错一个词,孩子的听写就废了。
- 保存:填教材名、单元、日期,存成任务。
保存的那一瞬间,服务端已经在后台把每句话的发音合成好、塞进缓存了。等孩子点开听写,每一句都是秒播——不是"点一下转圈三秒"。
三、听写机:为什么屏幕上看不到句子
这台机器的核心交互就一件事:按住才显示。
播放页只有五个按钮——上一句、播放/暂停、下一句、重新开始、设置。中间那一大块是句子区域,默认只显示一个虚线框,里面四个字"按住查看"。手指按下去,句子出现;松手,立刻消失;手指滑出区域,也算松手。
这个交互没什么技术含量,但它决定了这台机器能不能用:
- 没有它,孩子会盯着屏幕抄,听写就退化成"抄写";
- 有了它,孩子仍然可以核对——写完这句,按住看一眼对不对,松手继续。
播完一句也不会自动播下一句。听写的节奏应该由孩子掌握:写完、点下一句。小程序、网页、听写机三端行为一致,都是停在本句等操作。这一点被家里人夸过,说比之前用的 App"不催人"。
硬件与几个实现细节
| 项 | 规格 |
|---|---|
| 开发板 | ESP-Mosaico(ESP32-S31NRV16,16MB Flash + 16MB PSRAM) |
| 屏幕 | 480×480 AMOLED 触摸屏 |
| 音频 | 板载 codec(I2S + PA),MP3 软解码 |
| 框架 | ESP-IDF 6 + C++,UI 用 LVGL 9 |
| 缓存 | 独立 4MB LittleFS 分区,LRU 清理,约 3.5MB 音频 |
| 代码量 | 应用层 4147 行 C++,6 个模块 |
单任务状态机 + 消息队列。 UI 在 LVGL 自己的任务里刷,WiFi 和音频解码各跑各的,所有事件都转成消息发给唯一的控制器任务。网络请求再慢也不会卡住界面——这在 480×480 触摸屏上很关键,卡一帧用户就以为死机了。
音频二级缓存。 服务端的每句音频是按内容命名的(下面会讲),设备把同名文件存本地,第二遍听同一句完全离线、零请求。空间不够就删最久没听的。
语速在本地做。 0.5x 到 1.5x 五档,靠改解码采样率实现,改完立刻用新语速重播当前句。这样服务端不用为每个语速各存一份音频。
配网不装 App。 设备自己开热点,手机连上去自动弹配网页,选 WiFi、输密码,完事。
四、技术架构:能力全在服务端
整个系统的判断只有一句:不做"端侧各显神通",所有能力集中在服务端,三端都只是瘦客户端。
  家长端                          孩子端
┌──────────┐  ┌──────────┐   ┌──────────────┐
│ 微信小程序 │  │ 网页管理台 │   │ ESP32 听写机  │
└────┬─────┘  └────┬─────┘   └──────┬───────┘
     └─────────────┼────────────────┘
                   ▼
        ┌────────────────────┐
        │  自建服务端(云)    │
        │  账号 / 任务 / 进度  │
        │  AI 识别 / 语音合成  │
        │  音频缓存           │
        └──────────┬─────────┘
                   ▼
        微信登录 · 视觉模型 · 语音模型(密钥只在服务端)
好处很实在:换音色、换模型、改缓存策略,一处改完三端同时生效,不用重新发版;设备固件里没有任何密钥,丢了也只是丢一个 90 天的设备 token,家长后台一解绑就废。
几个具体决定:
内容寻址的音频缓存。 每句话的音频文件名,是"文本 + 音色 + 语速"的哈希。同一句话永远对应同一个文件,跨用户、跨设备共享。一句课文几百个孩子听过,也只合成一次。缓存键里带版本号,改请求结构就整体升版本,旧缓存自然淘汰——这条是被坑出来的,后面讲。
鉴权三主体,每次回库。 一套 JWT 管三种身份:家长(微信静默登录或账号密码)、设备(配对码换 90 天 token)。关键在"每次请求都回库查":账号被停用、设备被解绑,旧 token 当场失效。不查库的话,token 签发那一刻的状态会维持 90 天,中间怎么改权限都没用。
句子的唯一写入口。 句子的写入只有一个接口(整组替换),发音预热、缓存、进度全挂在这一个口子上。不做"多入口写入 + 事后对齐"——那是 bug 温床。
限流分档。 全局、语音合成、鉴权、识别各一档,按真实 IP。家庭项目最怕的不是被打,是自己脚本跑飞把额度烧了。
服务端目前 1504 行 Node.js、17 个文件、31 个接口、7 张表;网页管理台是 930 行的单文件 HTML(零构建零依赖,服务端直接托管);小程序 2452 行,零第三方依赖。
五、部署:一个人维护,最怕改完不敢上线
家庭项目死在"部署"这一步的不在少数。我最初的流程是三条命令手工敲:
git fetch && git reset --hard origin/main && docker compose up -d --build这套流程有四个隐患,而且我全踩过:
| 隐患 | 后果 |
|---|---|
| 用 sudo 操作仓库 | 产生 root 属主文件,下次普通用户 git 直接报 dubious ownership |
reset --hard | 静默吞掉服务器上的本地改动,连提示都没有 |
| 每次都全量 build | 只改一行文档也要等镜像重建 |
| 没有备份、没有健康校验 | 构建失败时站点直接停在新代码上,回不去 |
后来收敛成一条命令,六个步骤:比对新旧提交 → 打印变更预览并判断要不要重建 → 部署前做一次 SQLite 在线热备(保留最近 10 份)→ 只允许快进合并(工作区脏就拒绝并列出文件)→ 按需重建容器 → 轮询健康检查,超时自动回滚到旧提交并重建。
顺带补了几处细节:用 .gitattributes 强制脚本和配置为 LF(否则 Windows 上提交的文件到服务器会报 $'\r': command not found,这个错很费眼);容器日志轮转 10MB × 3 份防磁盘写满;支持 --dry-run 预演和定时自动部署。
现在从改完代码到线上生效,一条命令、一次喝水的功夫。这个投入比多写两个功能值。
六、踩过的坑
坑一:每句话都是不同的声音
最初接语音合成时,我把"音色"写在了请求体的顶层字段。文档里根本没有这个字段,接口默默忽略了它,模型自作主张,每句挑一个不同的说话人来读——一段听写听下来像五个人接力。
排查到官方文档深处才发现,音色必须放在 references 数组里的 speaker 字段。
修完还不算完。缓存里存的还是那些"随机音色"的音频,而缓存键是"文本 + 音色 + 语速"——音色参数没变,键就没变,改完代码照样命中旧音频。最后把缓存版本从 v1 升到 v2,让旧缓存整体失效,才算真正修好。
教训:接口不报错 ≠ 参数生效。 尤其是这类"参数可选、非法值静默忽略"的设计。
坑二:报错说"小程序未授权"
拍照识别一直弹"未授权",查了半天授权配置。真相是两层叠加:手机照片轻松超过 1MB,而服务端默认请求体上限就是 1MB,返回 413;前端拿到这个错误,误判成"云端没授权",转去走一条备用通道;备用通道要授权,于是报"未授权"。
最后是三处一起改:服务端把识别接口的请求体放宽到 12MB,前端上传前先把图片压到几百 KB,删掉那条会误导人的备用通道。
教训:前端把错误"翻译"成另一种错误,比不处理更糟。
坑三:上传小程序必报错
开发者工具里上传、清缓存、导入项目,全部报 access_token is invalid。代码查了半天空的——因为这个小程序是平台托管的,同一个 appid 的微信凭据由平台代持轮换,工具自己取的 token 一用就"过期",两边互相顶。
结论是:这类托管小程序,发布走平台通道,不在开发者工具里反复点上传。每重试一次,token 互顶就多一次。
坑四:解绑了,设备还能用
设备 token 有效期 90 天。最初的校验只查"这个家长账号还正常吗",不查设备记录是否还存在。
于是家长在后台点了"解绑",设备从列表里消失,可孩子手里那台机器照样能拉任务、照样能听写——直到 token 自然过期为止。
修复是每次设备请求都回查一次设备记录,绑定关系不存在就返回 401,设备收到 401 自动回配对页。顺手把"改绑给另一个账号"也做对了。
教训:权限校验要查"当前关系",不能只查"签发时的状态"。
坑五:部署脚本自己会挂
第一版脚本里有这么一行:
ls backups/*.db | xargs rm在 set -o pipefail 下,第一次部署时 backups 目录还不存在,ls 返回非零,整条管道判失败,脚本直接退出。补一个 || true 了事。
教训:开了 pipefail,每条管道都得当成"会失败"来写。
七、数据与隐私
- 所有数据在自己的云服务器上:SQLite 单文件 + 音频目录,备份就是拷文件;
- 不接任何统计、埋点;
- 服务端不落盘照片,识别完即丢;
- 孩子设备上只有任务文本和已下载的音频;
- 网页端注册开放但要管理员审核,陌生人进不来。
这是一个自用系统,从设计第一天就没打算做成产品。
八、几个常见问题
为什么设备上看不到句子?
听写考的是耳朵。默认隐藏、按住临时显示,是这台机器的核心交互,不是没做完。
孩子会不会自己把设备解绑了不写?
不会。设备上没有解绑入口,解绑只能家长在手机或网页端操作。设备一旦发现绑定失效,直接回配对页,必须家长生成新配对码才能再用。
同一句话会重复花钱合成吗?
不会。音频按内容寻址全局共享,一句只合成一次;设备端还有本地缓存,第二遍完全离线。
断网还能用吗?
听过的句子能离线重播,新句子要联网。
能不能绑两台设备?
能,一个账号最多 10 台,每台一个唯一设备码,后台逐台管理、逐台解绑。
九、写在最后
这个项目里没有一项技术是新的:拍照识别、语音合成、JWT、SQLite、LVGL、内容寻址缓存,都是现成的东西。
真正花时间的是把它们拼成一个"家里能天天用"的东西——孩子的听写不能在转圈,不能因为某天网不好就听不了,也不能因为家长手滑点了个按钮就失效。这些要求不在任何文档里,只能自己一条一条想到、一条一条补上。
代码量不大:服务端 1504 行、小程序 2452 行、网页 930 行、固件 4147 行,加 151 项自动化测试。9 天。
如果你也在给孩子找听写方案,或者想用 ESP32 做点"只干一件事"的小硬件,欢迎在评论区聊。后面我打算把固件和外壳的做法单独写一篇。
本文涉及的三端代码为个人项目,暂未开源;文中技术方案可自由参考。